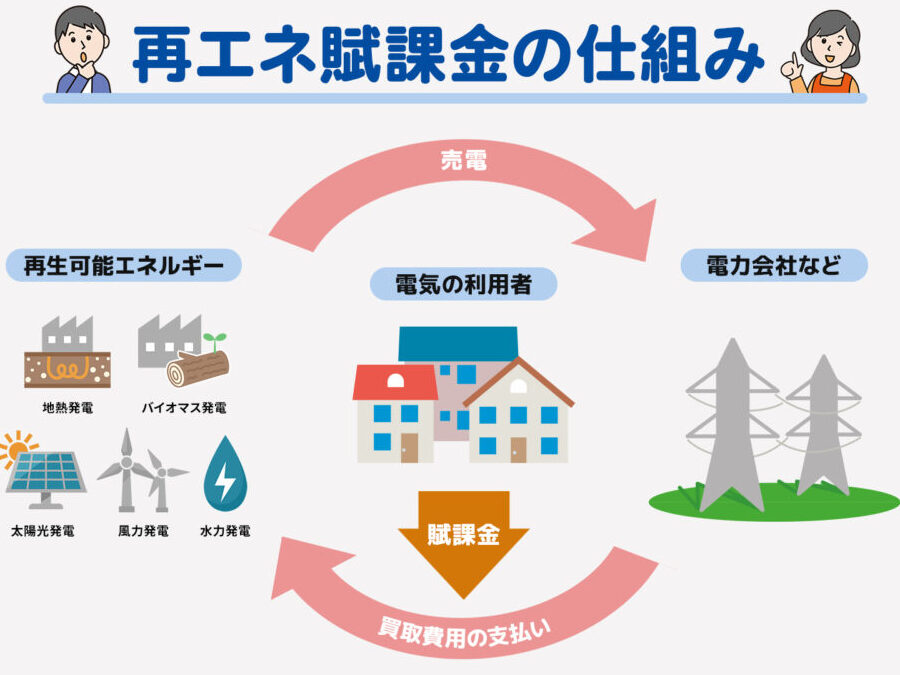
私たちは「賦課éã®æå³」について深く掘り下げることにしました。この言葉は単なる概念ではなく、私たちの文化や思考方法に密接に関連しています。具体的には、私たちがこの言葉をどのように理解し日常生活に取り入れているかを探ります。
この記事では、「賦課éã®æå³」の意味とその背景について詳しく解説します。また、この概念がどのようにして現代社会で活用されているかにも触れます。私たちと一緒にこの興味深いテーマを探求してみませんか?あなたは「賦課éã®æ¬å˜」がもたらす影響について考えたことがありますか?
賦課éã®æå³とは何か
言語モデルの構造とは何か
言語モデルは、特定のテキストデータを基にして、言葉や文章を生成するための計算機プログラムです。この技術は、自然言語処理(NLP)の一部として、多くのアプリケーションで活用されています。例えば、文章生成、自動翻訳、質問応答システムなどがその具体例です。私たちはこれらの技術がどのように機能し、その背後にあるメカニズムについて理解を深める必要があります。
言語モデルは一般的に以下の要素から構成されます:
- トレーニングデータ:膨大な量のテキストデータを収集し、それを使用してモデルを訓練します。
- アルゴリズム:データからパターンを学習するために使用される数学的手法や機械学習アルゴリズム。
- 出力層:新たな文章や単語を生成するために設計された部分。
これらの要素が相互作用することで、高度な予測能力を持つ言語モデルが形成されます。私たちが利用する際には、その精度と限界についても考慮することが重要です。
トレーニングプロセス
トレーニングプロセスでは、まず大量の文書や会話データから情報を抽出し、次にそれらから意味的関連性や文法規則を学びます。この過程で重要なのは、「教師あり学習」または「教師なし学習」と呼ばれる手法です。教師あり学習では正解データが与えられ、一方で教師なし学習では自律的にパターン認識します。この違いによって、得られる知識や応用範囲も変わります。
モデル評価指標
さらに、このようなモデルには評価指標も存在します。主なものには以下があります:
- 精度(Accuracy):生成された結果が正確である割合。
- BLEUスコア:翻訳タスクなどで使われる、自動生成されたテキストと人間による参照テキストとの類似度。
- 損失関数(Loss Function):トレーニング中に最小化されるべき数値で、誤り率などを示す。
これら指標によって我々はモデル性能について判断でき、更なる改善点も見えてきます。
賦課éã®æ£しい使用方法
言語モデルの利用方法
言語モデルは、多様な用途に応じて活用できる強力なツールです。私たちは、特定のタスクやニーズに合わせてその機能を最大限に引き出す方法を理解することが重要です。ここでは、一般的な利用法と具体的なアプローチについて詳しく説明します。
まず、言語モデルを使用する際には、そのデータ入力の質が結果に大きく影響します。このため、明確で簡潔な指示を与えることが求められます。また、文脈情報も含めると、モデルの応答精度が上昇します。以下は効果的な利用法です:
- 質問形式:具体的かつ直接的な質問を投げかけることで、期待される回答を得やすくなります。
- コンテキスト提供:必要に応じて背景情報や詳細設定を提供し、高度な情報生成につながります。
- フィードバックループ:モデルの出力結果に対して反応し、それによって次回の入力内容や方向性を調整することで改善が図れます。
例えば、自動翻訳機能では原文から適切に翻訳された文章が生成されるためには元の文章がシンプルである必要があります。加えて、ユーザー自身がどんなスタイルで翻訳してほしいか指定すると、更なるカスタマイズも可能になります。
また、多様性あるデータセットによって訓練された言語モデルは特定分野への適用性も高いため、それぞれのビジネスニーズや個別課題にも役立ちます。我々はこれらの特徴を生かし、新しいアイディア創造および業務効率化へとつながる成果を見込むことができます。
さらに、利用時にはセキュリティ面にも留意する必要があります。プライバシー保護として個人情報や機密情報は慎重に取り扱いましょう。そのため、安全で信頼できる環境下で運用すべきです。このように、一貫した手法とガイドラインによって言語モデルから最善の結果を引き出せるでしょう。
具体的な例を通じて理解する賦課é
å…·ä½çãªä¾ã‚éã�ã�¦ç解ã�ã‚賦課é
私たちは、具体的な例を通じて「言語モデルの意味」をより深く理解することができます。言語モデルは実際にどのように機能し、どのようなケースで有用なのかを示すことで、その能力や限界についても明らかになります。
例えば、検索エンジンでは、ユーザーが入力したクエリに基づいて関連性の高い情報を提供するために言語モデルが使われています。このプロセスでは、文脈を理解し、それに応じた結果を返すことが求められます。そのためには、大量のデータから学習した知識とパターン認識能力が不可欠です。
また、カスタマーサポートシステムでも同様の技術が活用されています。顧客から寄せられる質問やリクエストに対して迅速かつ正確な回答を提供するためには、高度な自然言語処理能力が必要です。これによって、人間と同様のコミュニケーション体験を提供できるようになっています。
次に、教育分野でもその利用価値は大いに発揮されています。個別指導や自習支援ツールとして機能し、生徒一人ひとりの学習進度や理解度に合わせて最適な教材や問題セットを提案します。このようにして、多様な学び方を支援することが可能になります。
さらに、「言語モデル」の具体的な利点として以下の点があります:
- 効率性:大量の情報処理を短時間で行える。
- パーソナライズ:ユーザーごとのニーズに応じたコンテンツ提供。
- アクセシビリティ:多様なバックグラウンドやスキルレベルへの対応力。
このような事例からもわかる通り、「言語モデル」は多岐にわたり応用されており、その可能性は日々拡大しています。我々は今後も新しい技術革新によって、この分野でさらなる発展を見ることになるでしょう。
可能性と限界についての考察
私たちが「言語モデルの概念」を理解する際、可能性と限界について考えることは非常に重要です。言語モデルの設計や運用においては、どのような状況でその能力を最大限発揮できるか、また、その性能にはどのような制約があるかを認識する必要があります。このセクションでは、これらの側面を詳しく探求していきます。
まず、私たちが注目すべきは、言語モデルが持つ可能性です。例えば、多様なデータセットから学習し、人間の会話を模倣し、新しいコンテンツを生成する能力などがあります。また、この技術は情報検索や自動翻訳など多くの分野で役立つことから、その応用範囲も広がっています。しかしながら、その効果的な利用には一定の条件や環境が必要です。
次に、限界について考えましょう。言語モデルにはいくつかの制約があります。例えば:
- 文脈理解: モデルは長期的な文脈を把握する能力に欠ける場合があります。
- バイアス: 学習データに基づき、不適切なバイアスや偏見を反映するリスクがあります。
- 創造性: 意外性や独自性に欠け、既存の情報から類推した内容しか生成できないこともあります。
これらの要素は、「言語モデル」の意義と機能を評価する上で不可欠です。我々自身もこの技術を利用することで得られる利点と、それによって生じる課題について真剣に考慮すべきでしょう。それぞれの場面で最適な結果を引き出すためには、自身が扱う情報や用途に対して正確な知識と理解が求められます。
結果として、可能性と限界とのバランス感覚こそが、「言語モデル」をより良く活用していくため의鍵となります。この姿勢こそ我々が今後進化させていくべき重要なポイントでしょう。
関連する他の用語とその違い
é¢é£ããä»ã®ç¨èªã¨ãã®éã
私たちが「言語モデルの概念」を理解する上で、外的要因や制限に関連する考察が重要です。その一環として、特定の言語で使用される表現方法について検討し、その影響を評価します。これにより、さまざまなコミュニケーションスタイルや文化的背景がどのように言語使用に反映されるかを明らかにします。
例えば、以下のような具体的なポイントがあります:
- 文脈依存性: 言語は状況によって異なる意味を持つことがあります。特定の単語やフレーズが異なる文化圏では違った解釈を生む可能性があります。
- 文化的ニュアンス: 特定の表現には、その文化特有の感情や価値観が込められていることがあります。これを理解することで、より深いコミュニケーションが図れます。
- 技術的制約: 技術的な側面も無視できません。例えば、自動翻訳ツールではニュアンスが失われることがあります。このため、人間による適切な判断と解釈が不可欠です。
また、このセクションでは、日本語および他言語との比較にも触れます。他言語で一般的に使われている表現と日本語独自の用法を対比し、それぞれの特徴や利点について考察します。この分析は、多様な視点から「言語モデル」の理解を深める助けとなります。
次に、具体例として日本語と英語で同じコンセプトを示す際の相違点について詳細に見てみましょう。それぞれの言葉遣いやフレーズ選択はどう変わってくるのでしょうか?この探求によって、私たちは異なる文化背景から学び合う機会を得られるでしょう。